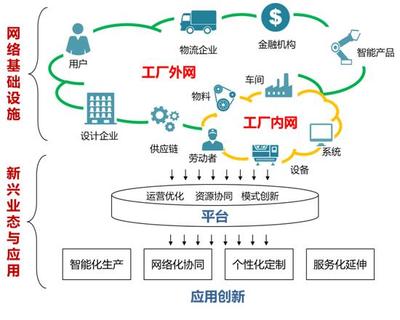
NVIDIA CPO技术引领AI工厂网络革新
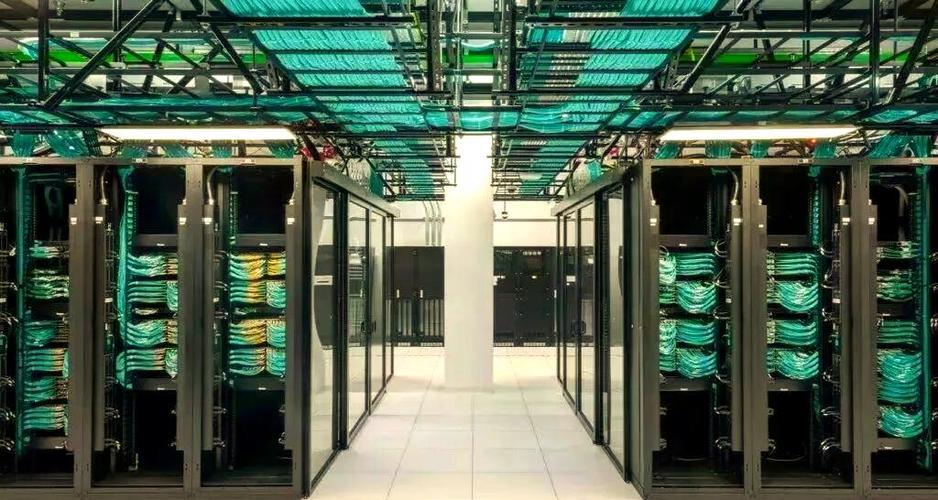
随着人工智能模型规模从百亿级迅速迈向万亿级,AI工厂已成为新型基础设施的核心形态。在这一体系中,网络不再只是连接计算的‘管道’,而是决定算力利用率与训练效率的关键瓶颈。NVIDIA 将共封装光学(Co-Packaged Optics, CPO)技术引入其 AI 网络产品路线,为AI工厂的互联架构带来了一次根本性革新。
传统可插拔光模块在高速率下遭遇功耗墙与信号完整性瓶颈。当单端口速率达到 800G 乃至 1.6T 时,电信号从交换芯片到面板光模块的长距离走线引入显著插入损耗,迫使系统采用更复杂的 DSP 与更强 FEC,功耗和延迟随之攀升。CPO 的核心思路是将光引擎与交换 ASIC 共同封装在同一基板上,把电互连距离从数十厘米缩短到毫米级,从而大幅降低 I/O 功耗、提升信号质量并压缩封装尺寸。NVIDIA 在硅光子与先进封装领域的持续投入,正是围绕这一方向构建面向 AI 工厂的网络基础。
为什么 AI 工厂比传统数据中心更需要 CPO?AI 训练负载具有强同步、高突发、全互联的特征。大规模 GPU 集群在 All-Reduce、All-to-All 等集合通信中要求网络具备极低时延与确定性抖动。万卡级集群的光互连数量成倍增长,光模块功耗已占网络总功耗的相当比例。CPO 通过降低每比特传输能耗,使网络交换层在相同功耗预算下承载更高带宽密度,减少散热压力与故障点(可插拔模块是数据中心现场故障的高发环节)。对 AI 工厂而言,这意味着更高的有效算力占比与更低的总体拥有成本(TCO)。
网络技术服务的内涵也因 CPO 发生变化。过去运维团队主要围绕光模块的选型、插拔与更换开展工作;而在 CPO 架构下,光引擎与交换芯片共同封装,系统集成度提高,现场可维护单元上移。网络技术服务由此转向从芯片、封装、光引擎到整机与集群的全栈协同:包括链路预算与光功率预算的精细化设计,液冷与风冷如何与光引擎热管理匹配,固件与遥测体系如何实现对光链路的在线健康监测,以及在集群部署阶段完成光电联合调试与端到端性能验证。服务机构需要具备硅光封装理解、系统级散热设计和自动化运维平台对接的综合能力,而不仅是单一模块级经验。
从产业角度看,CPO 代表了网络互连从‘可插拔生态’向‘封装内生态’的演进。它并非一夜替代可插拔方案,而是沿速率提升曲线分阶段落地:先在交换机侧高密度端口与 GPU 集群骨干层发挥优势,再随生态成熟向更广泛场景扩展。对建设 AI 工厂的用户而言,评估网络方案时应把光互连功耗、故障域、运维可达性与供应链成熟度纳入整体 TCO 模型,而非仅比较单端口速率参数。NVIDIA 以 CPO 为支点的网络技术布局,正在把 AI 工厂的网络从被动物理连接推向与计算、存储协同设计的一体化系统,而配套的网络技术服务能力,将成为决定这些系统能否稳定高效运行的关键一环。
如若转载,请注明出处:http://www.bzfrf.com/product/57.html
更新时间:2026-11-11 01:40:58